
근묵자흑
Learning eBPF 10-11장 : eBPF Programming 본문
Liz Rice의 Learning eBPF 10-11장을 다룹니다.
Pod가 설정 파일을 읽지 못하는 상황을 생각해 봅니다. 애플리케이션 로그에는 경로나 오류 원인이 없을 수 있습니다. 프로세스의 파일 열기 요청을 관찰하면 조사 범위를 좁힐 수 있습니다. 이 글에서는 openat()의 진입과 반환을 연결하는 추적기를 작성합니다. 이어 XDP 입력 검사, verifier의 거부, CO-RE와 프로그램 해제를 각각 확인합니다.
커널은 파일·메모리·네트워크 같은 시스템 자원을 관리합니다. 애플리케이션은 사용자 공간에서 실행합니다. 애플리케이션은 시스템 콜로 커널에 작업을 요청합니다. eBPF 프로그램을 필요한 이벤트 지점에 연결하면 그 지점을 지나는 작업을 관찰할 수 있습니다.
| 용어 | 이 글에서의 의미 |
|---|---|
| hook | 프로그램을 연결할 실행 지점입니다. 파일 열기 진입·반환 이벤트가 예입니다. |
| loader | BPF 프로그램과 map을 준비하고 커널에 로드를 요청하는 사용자 공간 코드입니다. |
| verifier | 로드할 BPF 프로그램의 메모리 접근 등 안전성 제약을 검사하는 커널 구성 요소입니다. |
| map | BPF 프로그램이 상태를 저장하거나 사용자 공간과 데이터를 공유하는 자료구조입니다. |
| TID / TGID | TID는 스레드 식별자입니다. TGID는 같은 프로세스의 스레드를 묶는 식별자입니다. |
| FD | 열린 파일 같은 자원을 가리키는 정수입니다. 0도 유효한 FD입니다. |
eBPF 개발 포인트
bpftrace: 장애를 조사할 때 짧은 추적부터 시작
bpftrace는 이벤트와 수행할 동작을 스크립트로 표현합니다. bpftrace는 커널 프로그램의 컴파일과 로드를 처리합니다. map 구성과 사용자 공간 출력도 상당 부분 처리합니다. 책은 execve 호출 집계와 opensnoop을 예로 들겠습니다.
tracepoint:syscalls:sys_enter_openat
{
    @[comm] = count();
}
첫 줄은 관찰할 이벤트입니다. comm은 현재 실행 주체의 이름입니다. @[comm]은 이 이름을 키로 쓰는 map입니다. count()는 이벤트 발생 횟수를 집계합니다. 이 코드는 프로세스 이름별로 openat() 진입 횟수를 집계합니다. 실패한 호출도 포함합니다. 서로 다른 프로세스나 Pod가 같은 comm을 사용할 수 있습니다. 운영 도구에서는 이름만으로 대상을 식별하지 않습니다.
tracepoint는 커널에 마련된 이벤트 지점을 사용합니다. kprobe는 커널 함수의 실행을 관찰합니다. 책의 kprobe:do_execve를 그대로 복사하기 전에는 bpftrace -l '*execve*'로 실제 hook을 확인해야 합니다. 내부 함수 이름은 커널 버전·아키텍처에 따라 달라질 수 있습니다. 이번 환경은 ARM64여서 존재를 확인한 openat tracepoint를 사용했습니다.
책의 bpftrace 내부 구현 설명은 당시 버전을 기준으로 읽어야 합니다. 이후 개발자들은 libbpf를 사용하는 방향으로 bpftrace를 개선했습니다. 따라서 모든 현재 버전을 "BCC 프로그램으로 변환하는 도구"라고 설명할 수는 없습니다. 실습은 설치된 bpftrace 0.20.2의 문법으로 작성했습니다. 개발자 발표: Modernizing bpftrace with libbpf
Go와 Rust: 기존 사용자 공간 서비스와의 결합
cilium/ebpf의 bpf2go는 C 코드를 컴파일하고 Go 코드를 생성합니다. 개발자는 생성한 Go 코드와 BPF 오브젝트를 함께 빌드해 Go 서비스에 넣을 수 있습니다. //go:generate는 실행할 명령을 적는 지시문입니다. 생성 단계는 go generate로 직접 실행합니다. 일반적인 go build는 이 생성 단계를 자동으로 실행하지 않습니다. 생성 단계를 생략하면 빌드 결과에 오래된 BPF 코드가 포함될 수 있습니다. cilium/ebpf
cgo는 Go 코드가 C 코드와 연결되는 기능입니다. libbpfgo는 이를 통해 libbpf를 Go에서 사용하도록 감쌉니다. libbpf 기능을 사용하는 구성에서 libbpfgo를 검토할 수 있습니다. cgo를 사용한다는 이유만으로 다른 방식보다 느리다고 단정하지 않습니다. libbpfgo
Rust에서는 libbpf-rs와 Aya의 경계가 다릅니다. libbpf-rs는 libbpf를 사용한 사용자 공간 개발을 지원합니다. Aya는 Rust로 eBPF를 로드하고 커널 코드를 개발하도록 지원합니다. Aya가 libbpf에 의존하지 않는다는 설명과 빌드 도구에서 LLVM이 필요 없다는 설명은 구분해야 합니다. 현재 Aya 개발 환경 안내에는 Rust toolchain과 bpf-linker 준비가 포함됩니다. libbpf-rs, Aya 개발 환경
로컬 실습
BPF_PROG_TEST_RUN으로 XDP 분기를 검증
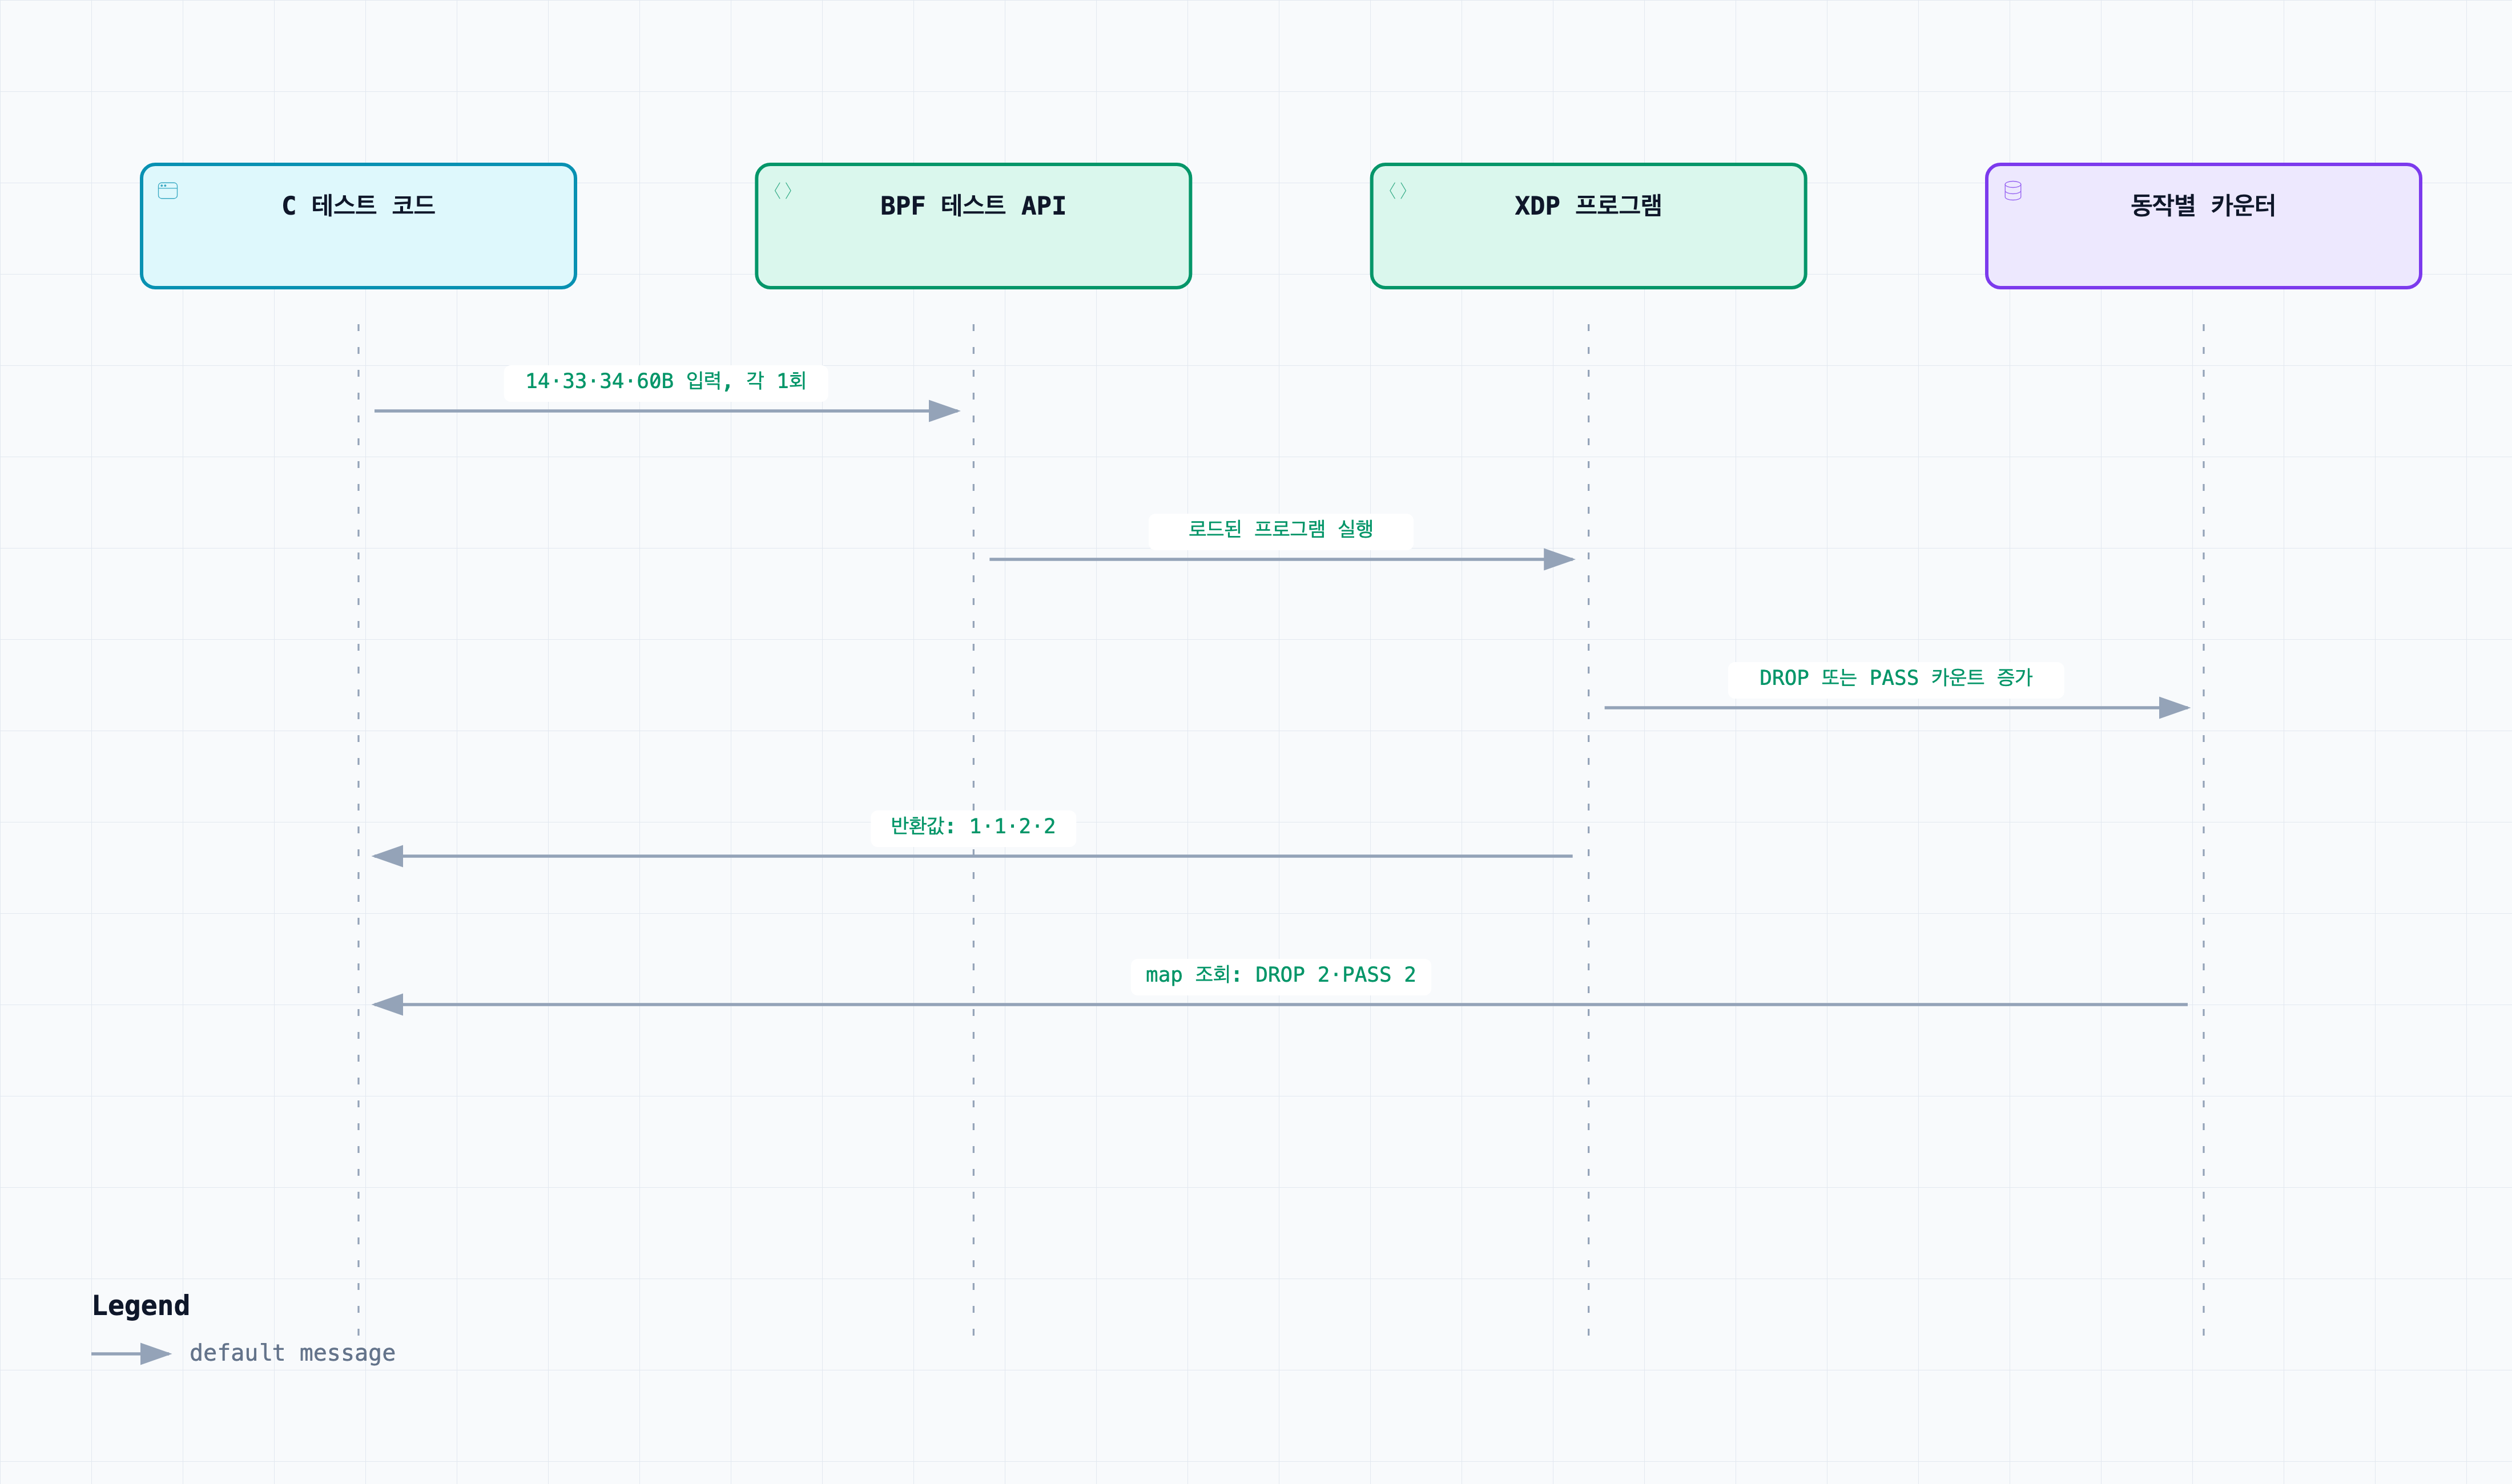
XDP는 네트워크 수신 경로에서 패킷을 다루는 eBPF 실행 지점입니다. 프로그램은 패킷을 계속 처리할지, 버릴지 등의 동작 값을 반환합니다. 여기서는 파일 추적과 별개의 작은 패킷 검사 코드를 사용해, 입력 데이터를 직접 넣고 반환값을 확인하는 테스트 방법을 익힙니다.
네트워크 패킷은 정해진 형식의 바이트 묶음입니다. 앞부분의 헤더에 프로토콜 정보 등이 담깁니다. 예제는 Ethernet 헤더 14바이트를 읽습니다. EtherType이 IPv4이면 IPv4 헤더의 최소 길이인 20바이트가 더 있는지 검사합니다. 짧은 입력에서 헤더가 있다고 가정하고 읽으면 유효한 데이터 범위를 벗어납니다.
책의 BPF_PROG_RUN은 BPF_PROG_TEST_RUN과 같은 명령 값의 이름입니다. libbpf에서는 bpf_prog_test_run_opts()를 사용했습니다. 이 API는 지원하는 프로그램 유형과 실행 옵션에 제약이 있습니다. 모든 tracing 프로그램을 호출할 수 있다고 가정하지 않습니다. 커널 문서: userspace에서 BPF 실행
packet.bpf.c는 Ethernet 헤더와 IPv4 최소 헤더의 범위만 검사합니다. IPv4 체크섬, IHL에 따른 옵션 길이, VLAN, ARP 본문은 검증하지 않습니다. 실무 패킷 필터로 배포할 코드는 아닙니다.
struct ethhdr *eth = data;
__u32 action = XDP_PASS;
if ((void *)(eth + 1) > end)
    action = XDP_DROP;
else if (eth->h_proto == bpf_htons(ETH_P_IP)) {
    struct iphdr *ip = (void *)(eth + 1);
    if ((void *)(ip + 1) > end)
        action = XDP_DROP;
}
data는 패킷 데이터의 시작입니다. end는 데이터가 끝나는 경계입니다. C에서 구조체 포인터 eth에 1을 더하면 Ethernet 헤더 한 개 크기만큼 이동합니다. 따라서 (eth + 1) > end는 헤더 하나를 읽을 공간도 부족하다는 뜻입니다. 반환값 XDP_DROP과 XDP_PASS는 각각 버리기와 계속 처리하기를 뜻합니다.
| 입력 길이 | EtherType | 검사하는 조건 | 실제 반환값 |
|---|---|---|---|
| 14바이트 | IPv4 | Ethernet만 있고 IPv4 헤더가 없음 | XDP_DROP = 1 |
| 33바이트 | IPv4 | 최소 길이보다 1바이트 부족 | XDP_DROP = 1 |
| 34바이트 | IPv4 | Ethernet 14 + IPv4 최소 20바이트 | XDP_PASS = 2 |
| 60바이트 | ARP | IPv4 검사 분기를 지나지 않음 | XDP_PASS = 2 |
PASS map action=1 count=2
PASS map action=2 count=2
반환값뿐 아니라 프로그램이 갱신한 map도 확인했습니다. 테스트 실행의 상태 변화가 실제 map에 남는다는 점을 보여 줍니다. 같은 map을 여러 테스트가 공유하면 이전 실행의 카운터가 다음 결과에 섞일 수 있습니다.
이 테스트는 NIC에 attach하지 않았고 실제 패킷을 송신하지 않았습니다. XDP_DROP을 반환했다는 사실을 실제 네트워크에서 패킷이 차단됐다는 결과로 쓰면 안 됩니다. 14바이트보다 짧은 입력은 테스트하지 않았습니다. 따라서 첫 번째 Ethernet 범위 검사 분기를 실행해서 검증하지는 않았습니다.
Kubernetes Pod의 파일 열기를 cgroup과 연결
Kubernetes의 Pod는 하나 이상의 컨테이너를 배치하는 단위입니다. Kubernetes namespace는 Pod 같은 리소스를 논리적으로 묶습니다. Linux의 PID namespace와는 다른 개념입니다. BusyBox는 이 실습에서 cat 같은 기본 명령을 실행할 작은 컨테이너 이미지로 사용했습니다.
실습은 별도 namespace와 BusyBox Pod를 만들고 /etc/hostname을 5번 읽습니다. 관찰기는 Pod 내부에 설치하지 않고 Lima 호스트에서 실행했습니다.
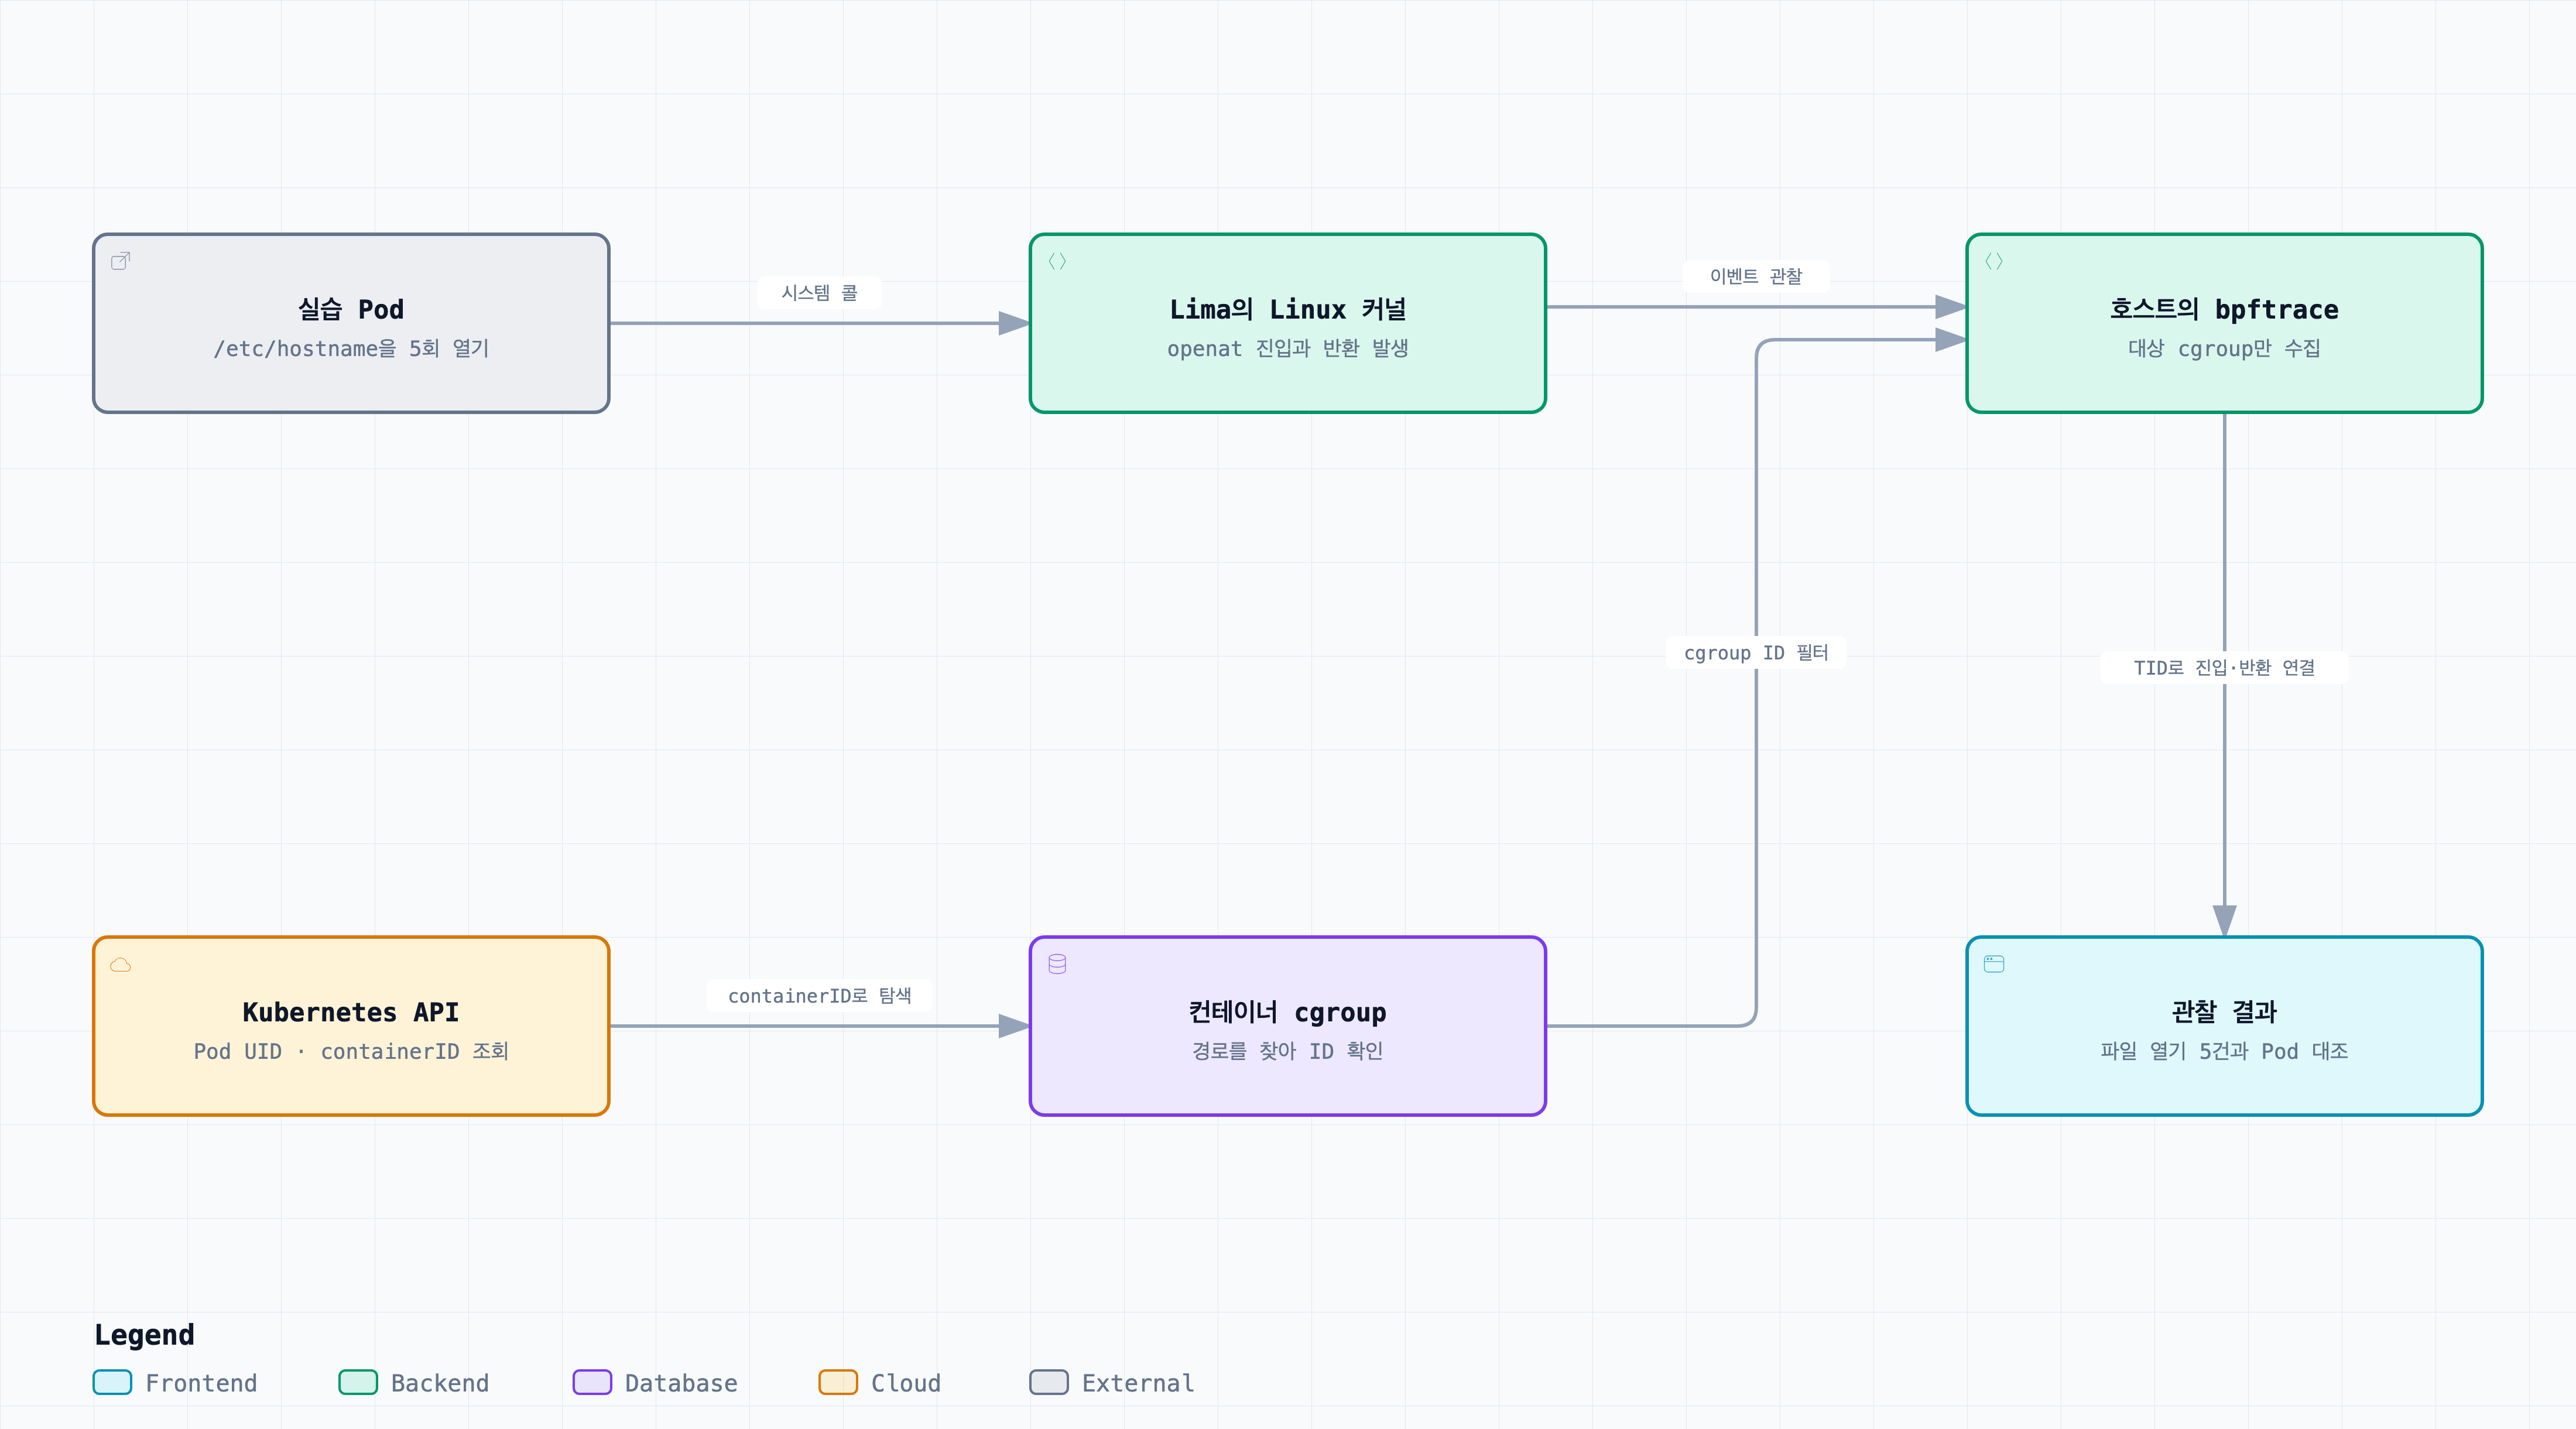
위쪽 경로는 Pod가 만든 파일 열기 이벤트를 호스트의 추적기가 관찰하는 흐름입니다. 아래쪽 경로는 Kubernetes API로 컨테이너를 식별합니다. 이어 해당 컨테이너의 cgroup ID를 찾아 추적기의 필터로 사용합니다. 그림의 bpftrace 상자는 커널 프로그램 준비와 사용자 공간 출력을 함께 담당하는 도구를 나타냅니다.
cgroup은 Linux에서 프로세스를 묶어 CPU·메모리 등의 자원을 관리하는 기능입니다. Kubernetes의 kubelet과 컨테이너 런타임도 이를 사용합니다. 관찰 도구에서는 프로세스가 속한 cgroup을 컨테이너를 찾는 단서로 활용할 수 있습니다. Kubernetes의 cgroup 설명
컨테이너 안에서 보이는 PID만으로 호스트 이벤트를 찾으면 번호가 맞지 않을 수 있습니다. PID namespace에 따라 같은 프로세스를 부르는 번호가 달라지기 때문입니다. 이번 실습에서는 Kubernetes API에서 얻은 containerID를 VM의 cgroup v2 경로와 연결했습니다. 해당 디렉터리의 inode 번호를 필터에 넣었습니다. inode 번호는 파일시스템에서 객체를 식별하는 번호입니다. 이벤트에서 관찰한 cgroup ID가 이 번호와 같은지 확인했습니다. 이 경로 탐색 방식은 이번 kind/containerd 실습을 위한 구현입니다. 여러 런타임을 지원하려면 컨테이너 수명을 처리하는 로직이 필요합니다. 메타데이터를 갱신하는 로직도 필요합니다.
실행 결과는 다음과 같습니다.
POD_OPEN host_pid=1377707 tid=1377707 cgroup=749886 ret=3 path=/etc/hostname
POD_OPEN host_pid=1377708 tid=1377708 cgroup=749886 ret=3 path=/etc/hostname
POD_OPEN host_pid=1377709 tid=1377709 cgroup=749886 ret=3 path=/etc/hostname
POD_OPEN host_pid=1377710 tid=1377710 cgroup=749886 ret=3 path=/etc/hostname
POD_OPEN host_pid=1377711 tid=1377711 cgroup=749886 ret=3 path=/etc/hostname
PASS Kubernetes: 5 opens, 5 successful exits, matching container cgroup, temporary map empty
CLEANUP temporary namespace removed; bpftrace process exited
이 실행의 Pod UID는 978b0a08-a577-42ef-892a-4a18ada326ec입니다. ID 값 자체를 다른 실행에 재사용하지 않습니다. 스크립트는 매번 생성한 Pod의 정보를 조회합니다.
기존 Cilium과 kube-proxy 설정은 변경하지 않았습니다. 이 결과는 노드 커널의 파일 이벤트를 Pod 메타데이터와 연결한 실습입니다.
CHAPTER 11: 책의 전망과 현재 eBPF 개발 현황 비교
2026년 10월 기준으로 책의 전망과 구현 상태를 비교합니다. ‘구현됨’은 실제 코드나 제품의 지원 기능을 확인했다는 뜻입니다. 운영 노드에서 바로 사용할 수 있다는 뜻은 아닙니다. 아래의 Linux 6.12는 소스를 확인한 버전이며, 각 기능이 처음 도입된 버전을 뜻하지 않습니다.
| 주제 | 책의 설명·전망 | 현재 구현 상태 | 검증 포인트 |
|---|---|---|---|
| 명령어 표준화 | 운영체제 간 eBPF 표준화 필요성을 설명함 | 규격 발행 완료. BPF 명령어와 의미를 정의한 ISA 규격 RFC 9669, 2024년 10월 발행 | Linux·Windows의 hook·helper·커널 구조체 호환성은 별도 확인 필요. Kubernetes 통합 방식은 규격 범위에 포함되지 않음 |
| Windows 지원 | Windows의 verifier·JIT 구성과 데모를 소개함 | 구현됨. eBPF for Windows는 bpf2c로 BPF 코드를 C로 변환한 뒤 Windows 드라이버로 빌드하는 native mode를 지원함 |
하이퍼바이저로 커널 코드 무결성을 보호하는 HVCI 환경에서는 JIT 제약으로 native mode를 사용함. 호환성 목표는 공통 hook·helper를 쓰는 소스 코드이며, Linux ELF의 직접 실행을 보장하지 않음 |
| 커널 객체 참조 유지 | 커널 포인터를 다음 BPF 실행에서도 사용하는 typed pointer 지원을 전망함 | 구현됨. referenced kptr와 bpf_kptr_xchg로 참조를 관리함. Linux 6.12 구현, kfunc 사용 규칙 확인 |
임의 주소 저장이 아닌 객체 참조 획득·반납 규칙 준수 필요. BPF에 노출한 커널 함수인 kfunc는 API 안정성을 강하게 보장하지 않음. CO-RE도 함수의 의미·인자 변경을 자동 해결하지 않음 |
| BPF 전용 메모리 할당 | BPF 프로그램의 자체 객체 할당을 전망함 | 구현됨. bpf_obj_new·bpf_obj_drop으로 객체를 할당·해제함. Linux 6.12 구현, 리스트·트리 사용 규칙 확인 |
일반 C의 malloc()과 사용 조건이 다름. 허용 타입·호출 문맥·객체 수명 규칙 준수 필요. 커널·라이브러리 조합 검증 필요 |
| 반복 처리 | 루프·helper 확장에 따른 표현력 향상을 전망함 | 구현됨. open-coded iterator는 시작·다음 항목·종료 함수로 반복함. 숫자 iterator의 bpf_iter_num_new 등을 Linux 6.12 소스에서 확인. iterator 설명 |
verifier가 허용하는 상태 전이·종료 조건 준수 필요. 대상 커널의 iterator·kfunc 지원 여부 확인 필요 |
| BPF 프로그램 서명 | CO-RE·map relocation의 바이트코드 변경으로 서명 검증이 어렵다고 설명함 | 처리 방식 확인, 구현 코드·정식 릴리스 포함 여부 미검증. 공식 설명은 loader·metadata 서명 방식을 제시함. 배포판에서의 사용 가능 여부는 미확인 | 서명은 출처·무결성을 확인함. 권한 검사·verifier 검사는 여전히 필요함. 서명 없는 프로그램을 거부하려면 LSM 등 커널 보안 정책으로 집행 필요 |
| BIG TCP | Linux 5.19의 BIG TCP와 고속 네트워크 활용을 소개함 | 구현됨. Cilium 지원 기능. IPv6는 커널 5.19 이상, IPv4는 6.3 이상 등 조건 존재 | GSO의 송신 분할 지연·GRO의 수신 패킷 병합으로 커널 내부의 큰 데이터 묶음을 활용함. 192KiB Ethernet 프레임을 물리 링크에 그대로 보내는 기능은 아님. MTU 변경 불필요. NIC·라우팅·암호화·터널 설정 확인 필요 |
| HID 장치 처리 | 키보드·마우스 등 HID 장치 지원 작업을 소개함 | 구현됨. HID-BPF는 struct_ops 기반 이벤트 처리와 장치 데이터 형식 설명인 report descriptor 수정을 지원함. Linux 6.12 구현, HID-BPF 설명 |
대상 장치·커널의 HID-BPF 지원 여부 확인 필요. 커널 버전에 따라 사용 가능한 API가 다를 수 있음 |
| 스케줄러 확장 | 더 많은 커널 기능을 eBPF로 확장할 것으로 전망함 | 구현됨. Linux 6.12의 sched_ext는 BPF 기반 CPU 스케줄링 정책을 지원함. 책의 전망과 비교하는 추가 사례 |
스케줄러는 작업에 CPU 시간을 배분함. sched_ext의 struct_ops·관련 kfunc는 ABI 안정성을 보장하지 않음. 커널 업데이트마다 호환성 검증 필요 |
| eBPF 기반 운영 도구 | 대부분의 사용자가 BPF 코드를 직접 작성하기보다 eBPF 기반 도구를 사용할 것으로 전망함 | 제품 기능으로 구현됨. Cilium은 cgroup hook 기반 socket load balancing과 kube-proxy replacement를 지원함 | Kubernetes Service의 Pod 접근 주소·연결 규칙을 설정에 따라 eBPF로 처리함. eBPF는 Kubernetes의 필수 조건이 아님. 선택한 네트워크 플러그인·관찰·보안 도구와 실제 활성화 설정 확인 필요 |
'k8s > learning-ebpf' 카테고리의 다른 글
| Learning eBPF 9장 : eBPF for Security (0) | 2026.09.19 |
|---|---|
| Learning eBPF 8장 : eBPF for Networking (0) | 2026.09.12 |
| Learning eBPF : Falco (0) | 2026.09.05 |
| Learning eBPF 7장 : eBPF Program and Attachment Types (0) | 2026.08.29 |
| Learning eBPF 6장 : eBPF Verifier (2) | 2026.08.22 |
